「AI Agentを加速するデータ基盤とは?」 #DCT_findy 受講メモ
AI使ってメモしてます
Findy主催のお昼1時間のオンラインイベント。FindyとSansanの2社が、AI Agentを支えるデータ分析基盤の設計思想と事例を紹介するランチセッションでした。
セッション
事業成長とAI活用を止めないデータ基盤アーキテクチャの設計思想
ファインディ株式会社 / 開 功昂さん
- CTO室データソリューションチームのマネージャー。前職のAIコンサルでデータエンジニアを経験し、2023年11月にファインディ入社。データ基盤がない状態からプロジェクト化して設計・開発をリード
- 今回の事例は社内向けデータ分析基盤の話。組織の拡大とAIの台頭がある中で、状況に合わせてアーキテクチャを見直すことの大切さがテーマ
- 2025年1月時点のアーキテクチャは、事業・組織ごとにデータ運用を分けるデータメッシュ的な考え方
- マルチプロダクト展開に合わせて、Google Cloudプロジェクトもインフラも技術選定も事業ごとに自由に選べる構成
- その結果、変換はDataformとdbt、データロードはDatastreamとEmbulkが混在するなど、事業間の技術差分が顕著になっていった
- 2026年に向けた課題整理では「変えられない前提」を先に固めたのが印象的
- 事業・組織の拡大は今後も続く、AI活用によるジョブ数増加も止めない、データエンジニアは市場的に採用が難しく少数精鋭のまま
- その上で、AIで運用や分析をうまく回す土台作りに専念する方針へ
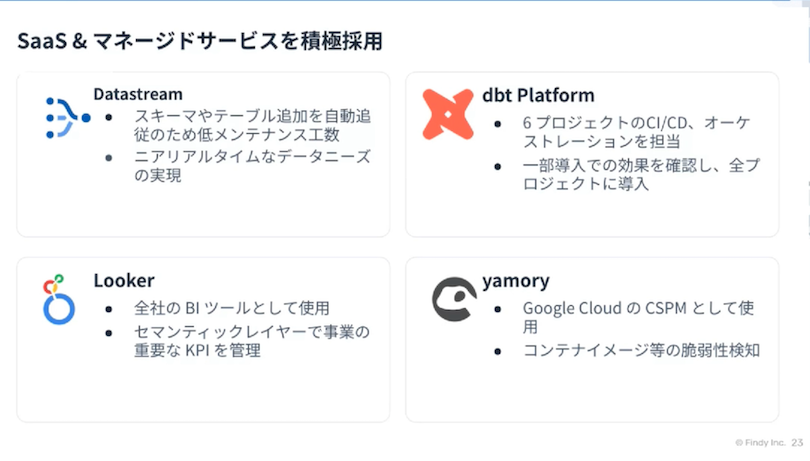
- 取り組み1:SaaS・マネージドサービスの積極採用
- データロードはDatastreamに標準化(スキーマ・テーブル追加の自動追従で低メンテ、ニアリアルタイム)
- 変換はdbt Platformに統一し、6プロジェクトのCI/CDとオーケストレーションを担当
- 全社BIツールとしてLookerを導入し、セマンティックレイヤーで事業の重要KPIを管理
- セキュリティはyamoryでGoogle CloudのCSPMとコンテナイメージの脆弱性検知をカバー
- 取り組み2:構成の統一と技術標準化
- 分かれていたGoogle Cloudプロジェクトを統一し、データセット単位で分ける形に変更。Terraformリポジトリも一本化を推進
- Dataformをdbtへ、Embulkをdatastreamへ置き換えて技術標準を制定
- チームの役割も「プラットフォーム」と「イネーブリング」に明確化し、それぞれ別のKPIを追う体制に
- プラットフォーム側はTerraformのモジュール化による共通利用、セキュリティ・コスト対応の巻き取りなど
- 標準化でオペレーションが型化できると、そのままAIスキル化できる。社内のデータエンジニアリングプラグインを入れるとClaude Codeで運用の一次対応レベルはこなせる状態になっていて、事業部サイドのデータアナリストがデータ基盤の運用に染み出せるようになりつつある
- イネーブリング側はデータ×AI活用の推進。活用度合いを3段階に整理して注力ターゲットを明確化
- ターゲットは「SQLは書けないけどデータを使いたい」データ顕在層。誤った活用を独自に進めてしまうリスクに先手を打つ意味もある
- ヘビーユーザーはBigQueryのMCPを自分で接続して確認できるので対象外、潜在層もリソースの関係で一旦対象外
- Lookerの会話分析機能でエージェントを立てて、データ抽出・分析を省力化。アナリストにデータ抽出依頼がいかない状態を実現できている
- 整備してきたセマンティックレイヤーの資産があったから組み立てられた。指標の一貫性と使用データが決まった状態でAIエージェントを提供できる
- 「うまく答えられなかった」という社内フィードバックをそのまま評価ケースに追加し、システムプロンプトを直すのかデータモデリングを直すのかを判断するサイクルが回っている
- 現場で使われる言葉や気づけていなかったビジネスイベントが浮き彫りになり、データモデリング見直しのネタにもなる
- 見えてきた課題は、経営層・社外向けに問われるデータ品質と指標の説明可能性、そしてAIエージェント投資に伴うコストの適正化
セマンティックレイヤーを先に整備していたからこそ、Lookerの会話分析にすっと乗れた。エージェントを作る前にデータの意味定義を揃える。 「標準化=型化=AIスキル化」。技術標準を定めることがそのままAIエージェントに運用を任せる下準備になるという見方は、基盤整備のモチベーション。イネーブリング対象を「SQLは書けないけどデータを使いたい層」に絞る割り切り。
顧客に提供して見えたAIエージェント設計のリアル
Sansan株式会社 / 瀬戸 博則さん
- SIerでBI・データエンジニアからキャリアを始め、事業会社の社内データ分析基盤、広告代理店でのクライアントワークを経て2025年にSansan入社。Sansan AIエージェントのFDE(Forward Deployed Engineer)のマネジメントとPdMを兼務
- 前セッションが社内向けだったのに対し、こちらは社外向けにAIエージェントサービスを顧客提供する話。社外プロダクトゆえ詳細は出せないので、設計上大切にしている考え方が中心
- Sansan AIエージェントは「できる営業の動き、誰でも再現できていますか?」がコンセプト。優秀な人だけが出せていた成果を誰でも再現できる仕組みを提供するプロダクト
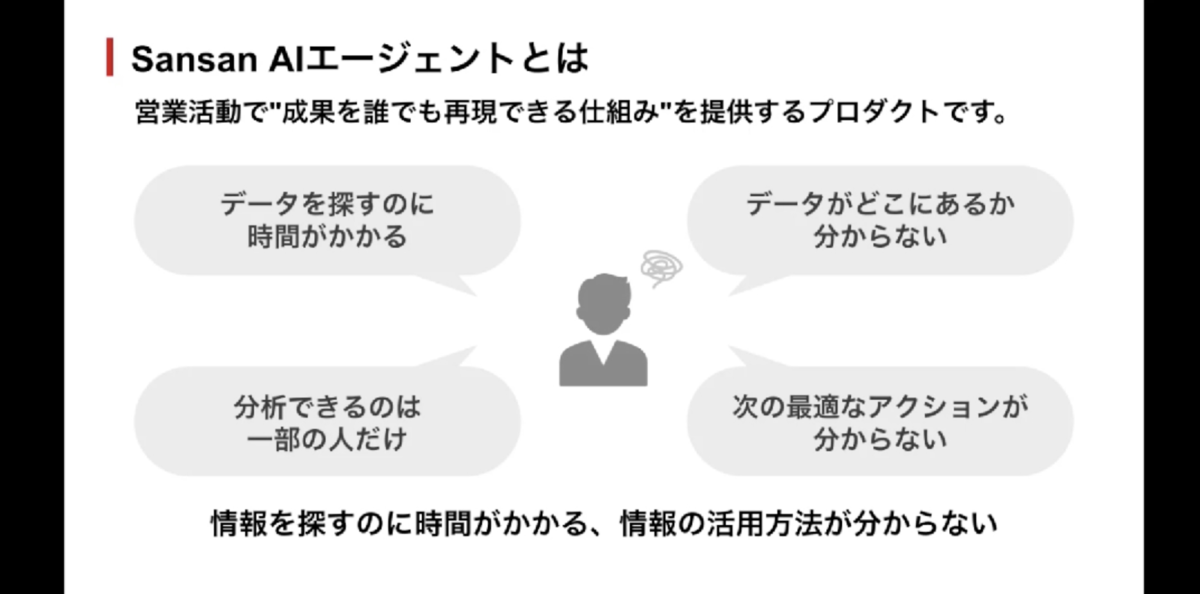
- 営業活動は属人化しやすく、情報探索の対象データも多岐にわたる。情報を探すのに時間がかかる、データがどこにあるか分からない、分析できるのは一部の人だけ、次の最適なアクションが分からない、という課題が根強い
- ユースケース例:引き継ぎゼロのまま3日後に既存顧客との商談を控えた営業担当
- 顧客が保持するデータとSansanが保持する企業情報を名寄せ技術で統合し、業種・拠点からIR・有価証券報告書相当まで包括的な企業プロフィールを提示
- 名刺交換を起点にした接点情報や商談履歴から人物プロフィールや意外な共通点を取得してアイスブレイクに活用。別部署で起きた納期遅れのような過去トラブルの要因分析も事前に把握できる
- 設計思想は「すでにある仕組みは作り直さない。自分たちしか出せない価値に集中する」。機能配置を4層で整理
- L1インタラクション層(ユーザーの入り口)、L2エージェント層(指示文からのエージェント差配と目的別サブエージェント群)、L3コンテキスト層(個社の戦略・商習慣・行動の型・ドメイン知識)、L4データベース層(顧客の基幹システム、SFA、Notion、Slack/Teamsなど)
- 価値の中心で競合優位性があるのはL3とL4
- インタラクション層はチャットとセッション履歴の最低限に抑えている
- UIを何個も立ち上げてそれぞれ分離しているのはナンセンスで、業務の延長線上でAIを使う形が主流になる。普段使うSFAやコミュニケーションツールからエージェントをAPI経由で呼び、既存の業務プロセスに組み込む方が合理的
- LLMクライアント側の進化が速く、UIを作り込むほど追従コストで負債になる。だから他の層にリソースを投下する
- エージェント層は個社別の業務ユースケースに合わせたタスク志向型。「プリセット」としてユースケースを定義し、そこからエージェントの差配と目的別サブエージェントが呼び出される仕組み
- コンテキスト層では暗黙知を「個社DNA」として形式化・資産化。カテゴリーは大きく3つ
- 個社の戦略(営業戦略、KGI/KPI、商品特性、業界特性)
- 行動の型(ハイパフォーマーの商談の進め方、提案の流れ、顧客対応で気をつけるポイントの言語化)
- 業務プロセス(エージェントとの会話履歴、担当企業・担当商品・役割、リードから契約までの営業プロセスなど)
- 現状はYAMLとMarkdownの階層管理でサブエージェントのワークフローに組み込むベーシックな方法。ただユースケースの増加・複雑化でコンテキストサイズが増え、現実との整合性が崩れてハルシネーションやコスト増につながる。オントロジー、ベクトル化、鮮度管理、キーワードヒット率のランキングなど、どの組み合わせが必要かをまだ検証中
- データベース層は、名刺データを企業・事業所単位で集約し続けた独自の名寄せエンジンが肝
- マスターデータと顧客の売上データ・部署データに一意のコードを振って統合できる名寄せ資産が、他社が真似しにくい価値の源泉。その上にdbtとディメンショナルモデリングで個社ごとに再利用可能なデータ層を構築
- FDEは全部の層に対して、個社の課題解決とアウトカムのために必要なことを何でもやる
- 暗黙知の形式化・構造化は顧客自身でも難しく、めちゃくちゃ泥臭い仕事が多い。課題設定と現状把握に時間をかけ、ユースケースが見つかったら2〜3日単位でプロトタイプ→フィードバック→修正を繰り返す
- 環境構成は何回かピボットした結果、Google Cloudに寄せたシンプルな構成。1コンテナ1テナントで分離し、Cloud Runでフロントもエージェントも MCPも動かし、BigQueryとdbtで裏側を制御
- 顧客提供ならではの苦労点1:非機能要件がめちゃくちゃ求められる
- 機能を作るコストはAI駆動開発で確実に下がったが、自社と顧客それぞれのセキュリティポリシー対応が重い。データ保持リージョン、Web検索の入力に顧客データが混ざる可能性の制御など
- Grounding with Google SearchのEnterprise版で保存期間を短くする、検索内容を出力画面に表示しないといった工夫で要件対応。プロンプトインジェクションには入力サニタイズ・権限分離・Model Armorでの悪意URL/ジェイルブレイク検知と多層防御
- 機能を作ることよりも、この辺の調整・合意形成・書面化・すり合わせが一番大変
- 苦労点2:個社に寄せすぎるとFDEのヘッドカウントが律速になって事業がスケールしない
- 共通になる骨格をなるべく抽象化して量産し、個社の差分は設定に閉じ込める方針。ただ共通化と個別化の線引きの最適解はまだ見つかっていない。1レポート1マートの個別最適か汎用データマートかという古典的な問題と同じ構図
- 苦労点3:出力の再現性。売上や取引実績を間違えると商談自体がまずくなる
- セマンティックレイヤーで金額の値の再現性を担保する一方、ロジックをツールに寄せて堅牢にしすぎると自然言語でのアドホック分析に対応しきれない。ゴールデンクエリなども含め、どのレイヤーでどう制御するか検証中
- 今後はFDEの個社対応作業の自動化・機能化を進めつつ、情報探索・補助のツールからアクションを代替するところまで踏み込みたい
インタラクション層を最低限にして、コンテキスト層とデータ層に投資を集中する割り切り。UIは作り込むほどLLMクライアントの進化に対する追従コストで負債化する、業務の延長線上にAIを置く。
